
Normalisation des données candidats : la méthode complète pour recruteurs
Normalisez vos données candidats pour obtenir une base unifiée et dédoublonnée, prête à la mise en correspondance et à l'engagement multicanal.
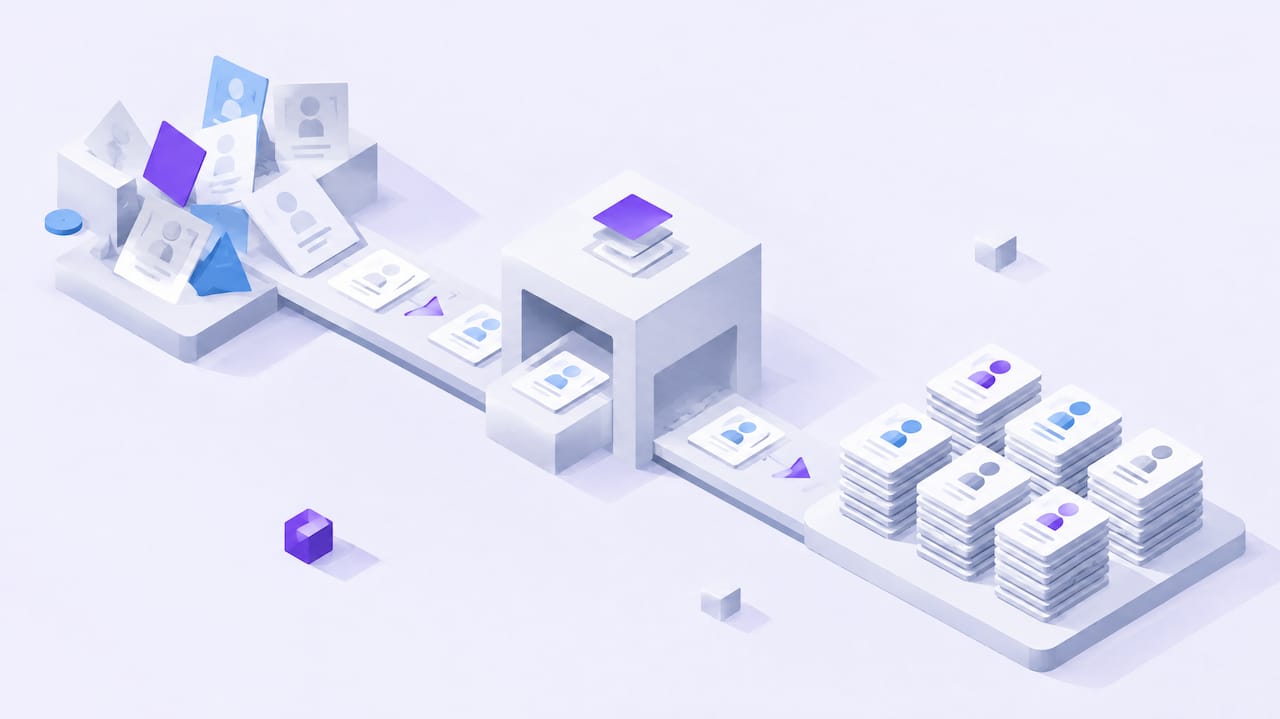
Normaliser vos données candidats signifie produire une base unifiée, dédupliquée et formatée (E.164, ISO 8601, RFC) prête au matching et à l’engagement multicanal. Concrètement, cela passe par cinq étapes : audit, déduplication, validation, normalisation et enrichissement, suivies d’un contrôle qualité avant export. Une plateforme de sourcing comme Kalent illustre bien ce que donne une base déjà nettoyée à grande échelle.
En bref:
- La déduplication avant la normalisation évite de traiter deux fois le même candidat sous des formats différents, réduisant erreurs et inefficacités.
- La validation stricte des champs critiques comme l’e-mail et le téléphone garantit une base fiable avant tout enrichissement ou normalisation.
- Un audit initial sur un échantillon permet d’évaluer si le nettoyage est un simple ajustement ou un projet complexe nécessitant plusieurs semaines.
- L’automatisation doit inclure une revue humaine des doublons avec un score de confiance, pour éviter des fusions erronées et préserver la qualité des données.
Table des matières
- Pourquoi normaliser les données candidats et quels gains concrets attendre
- Flux recommandé : audit, déduplication, validation, normalisation, enrichissement, QA
- Normaliser téléphones, e-mails et dates : règles techniques et outils recommandés
- Mapping métier : harmoniser intitulés, compétences et stades de cycle
- KPIs, checklist QA et cibles à viser avant intégration ou campagne
- Industrialiser avec des outils et preuves terrain
- Quand internaliser la normalisation et quand s’appuyer sur une plateforme
- Comment Kalent met en pratique cette normalisation et accélère le sourcing
- Questions fréquentes
- Sources
Pourquoi normaliser les données candidats et quels gains concrets attendre
Une base de candidats mal formatée casse le matching avant même qu’il commence : un numéro sans indicatif, une date illisible ou un intitulé de poste écrit de dix façons différentes réduisent mécaniquement la pertinence des résultats. La qualité des données en entrée conditionne directement la fiabilité des modèles utilisés pour le matching, un principe que formalise la norme ISO/IEC 5259-3 consacrée à la gestion de la qualité des données pour l’IA et le machine learning.
Un cadre de gestion de la qualité des données, comme celui décrit par l’ISO/IEC 5259-3, aide à structurer les seuils de validation et la traçabilité des corrections apportées à une base candidats.
Les gains attendus se mesurent à plusieurs niveaux :
- Moins d’erreurs de routage lors des campagnes d’e-mailing ou de SMS.
- Des séquences d’engagement qui atteignent réellement les bons contacts, sur les bons canaux.
- Un temps de traitement réduit pour les équipes sourcing, qui ne corrigent plus manuellement chaque fiche avant envoi.
- Une base exploitable directement par un outil de matching sans retouche en aval.
Ces bénéfices ne relèvent pas du confort : ils déterminent si une campagne d’approche atteint sa cible ou s’épuise dans des bonds et rejets techniques.
Flux recommandé : audit, déduplication, validation, normalisation, enrichissement, QA
L’ordre des opérations n’est pas arbitraire. Dédupliquer avant de normaliser évite de traiter deux fois le même enregistrement sous deux formats différents, et valider avant d’enrichir empêche d’investir du temps d’enrichissement sur des données qui seront de toute façon rejetées. Un guide pratique sur la migration et le nettoyage de données détaille cette logique : déduplication, puis validation des e-mails, puis normalisation des téléphones et dates, puis enrichissement, puis contrôle qualité final.
Voici la marche à suivre pour une équipe qui démarre ce chantier :
- Lancer un audit sur échantillon de 100 à 200 fiches pour identifier les types de doublons présents : ré-applications, variantes de nom, données de test ou de démonstration.
- Classer les doublons par niveau de confiance : une correspondance exacte sur l’e-mail autorise un auto-merge, tout le reste part dans une file de revue humaine.
- Valider les champs critiques (e-mail, téléphone) avant toute étape d’enrichissement, pour ne pas enrichir des contacts invalides.
- Normaliser les formats (téléphone, date, intitulés) une fois la base dédupliquée et validée.
- Documenter chaque règle appliquée afin de pouvoir l’auditer et la recalibrer plus tard.
Cette approche, qui distingue audit, file de revue humaine et automatisation progressive, correspond aux pratiques recommandées pour la détection de doublons dans un pipeline de candidats. Un audit initial sur échantillon révèle rapidement si le nettoyage est un ajustement de quelques heures ou un chantier de plusieurs semaines, ce qui permet de calibrer les ressources en conséquence.
Conseil de pro : demandez à votre outil d’IA de générer une liste de doublons probables avec un score de confiance et l’identifiant des enregistrements concernés, plutôt que de lui laisser fusionner automatiquement : la fusion reste une décision humaine tant que la correspondance n’est pas exacte.
Normaliser téléphones, e-mails et dates : règles techniques et outils recommandés
Trois champs concentrent l’essentiel des erreurs de normalisation : le téléphone, l’e-mail et la date. Pour les numéros, la cible est le format international E.164, qui limite chaque numéro à un maximum de 15 chiffres et structure la donnée en indicatif pays, code de destination national et numéro d’abonné, selon la recommandation ITU-T E.164.
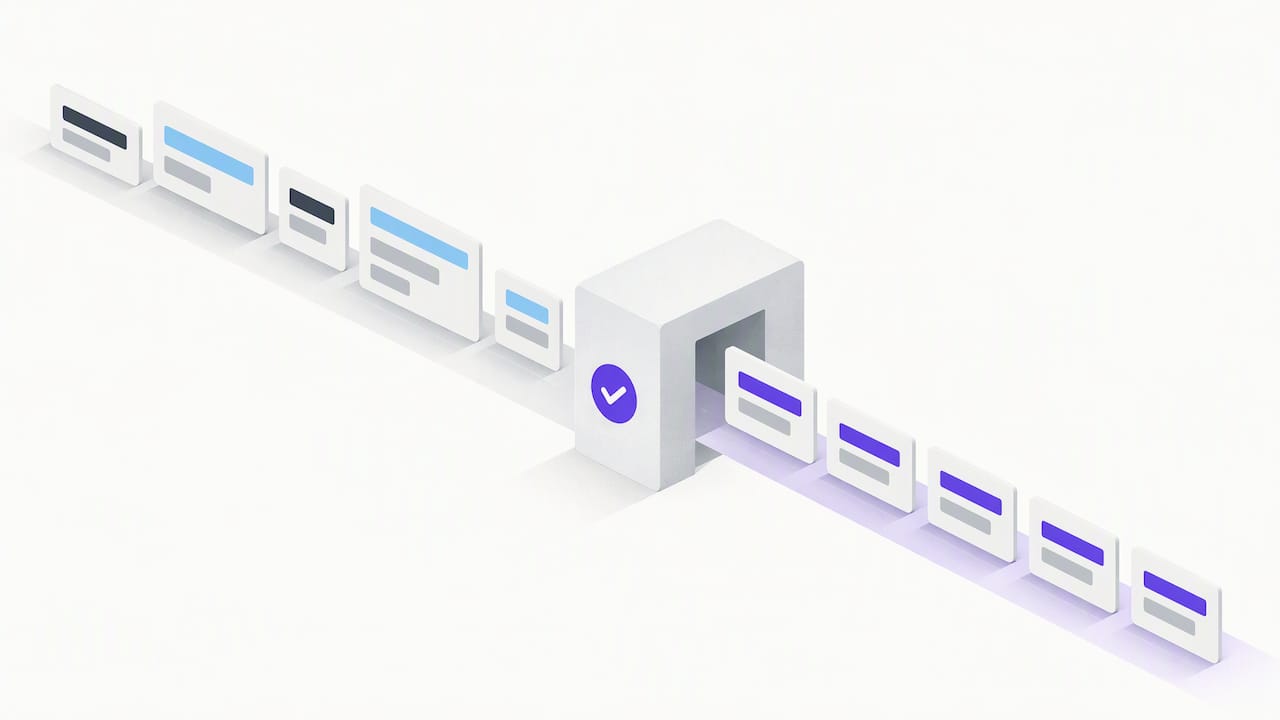
La norme E.164 fixe une longueur maximale de 15 chiffres pour un numéro international, ce qui en fait un format fiable pour le routage SMS et les appels automatisés.
Pour fiabiliser ce parsing, la librairie libphonenumber fournit des métadonnées par pays et documente les pièges courants, comme un zéro initial à retirer ou une extension du type « x102 » à isoler avant stockage.
Pour les e-mails, le respect du format décrit dans la spécification SMTP RFC 5321 impose une adresse structurée en partie locale et domaine pleinement qualifié, condition de base avant toute vérification plus poussée (existence d’un enregistrement MX, par exemple).
Quelques pièges fréquents à traiter systématiquement :
- Un numéro local saisi sans indicatif pays, qui devient inexploitable pour une campagne internationale.
- Une extension de poste fixe collée au numéro principal sans séparateur.
- Une date au format texte libre, impossible à trier ou comparer sans conversion.
- Un domaine e-mail mal orthographié qui passe une validation syntaxique mais échoue à la livraison.
Les dates, enfin, se stockent en ISO 8601 (AAAA-MM-JJ), seul format qui élimine l’ambiguïté entre notations américaine et européenne et facilite le tri chronologique des candidatures.
Mapping métier : harmoniser intitulés, compétences et stades de cycle
Les intitulés de poste et les compétences arrivent rarement sous une forme homogène : « Dev Full Stack », « Développeur Full-Stack » et « FS Developer » désignent la même réalité sans être reconnus comme identiques par un moteur de recherche classique. La méthode consiste à construire une taxonomie cible, puis à y rattacher chaque variante rencontrée.
- Exporter toutes les valeurs distinctes présentes dans la base pour un champ donné (intitulés, compétences, statut).
- Prioriser par fréquence pour traiter d’abord les variantes qui concernent le plus grand nombre de fiches.
- Construire une table de mapping qui regroupe les synonymes sous une valeur cible unique, avec une règle de repli pour les cas non reconnus.
- Valider par échantillonnage en vérifiant qu’un lot de fiches mappées correspond bien à l’intention d’origine.
Un cycle de candidature compte souvent neuf statuts différents selon les ATS (candidature reçue, en revue, entretien planifié, entretien passé, test technique, offre faite, offre acceptée, refusé, abandonné) qui se ramènent utilement à quatre étapes cibles : nouveau, en cours, offre, clôturé.
KPIs, checklist QA et cibles à viser avant intégration ou campagne
Avant d’exporter une base vers un ATS ou de lancer une campagne d’engagement, quelques indicateurs permettent de vérifier objectivement que le nettoyage a atteint son objectif plutôt que de se fier à une impression.
La checklist finale avant mise en production tient en trois gestes : un envoi test à faible échelle pour vérifier le taux de rebond réel, une dernière revue humaine sur l’échantillon signalé comme incertain, et un import en environnement sandbox avant la bascule définitive dans l’ATS de production.
Industrialiser avec des outils et preuves terrain
Une fois la méthode posée, l’enjeu devient la répétition : relancer le nettoyage à chaque import, pas seulement une fois. Les intégrations natives entre un outil de sourcing et l’ATS évitent de ressaisir ou de reformater les données à chaque export vers le pipeline RH.
- Programmer des jobs périodiques de contrôle qualité plutôt qu’un nettoyage ponctuel qui se dégrade avec le temps.
- Conserver une sauvegarde avant chaque passage de normalisation automatisée, pour pouvoir revenir en arrière.
- Suivre dans le temps les mêmes indicateurs (taux d’e-mails valides, taux E.164) pour détecter une dérive.
Sur ce terrain, notre moteur de recherche de talents s’appuie sur une base enrichie avec une part élevée de numéros mobiles et d’e-mails personnels exploitables parmi plus de 200 millions de profils disponibles en Europe et aux États-Unis, ce qui évite à nos clients de reconstruire cette couche de normalisation en interne. L’automatisation du contact via LinkedIn, e-mail et WhatsApp s’appuie directement sur ces données normalisées pour réduire le temps de sourcing de moitié.
Conseil de pro : avant de confier un lot de données à un outil d’IA externe, vérifiez quelles informations sont réellement transmises : un article sur l’usage d’outils IA sans partage de données personnelles détaille les précautions à prendre.
Quand internaliser la normalisation et quand s’appuyer sur une plateforme
Internaliser a du sens quand les volumes restent modestes et que l’équipe dispose de compétences techniques pour maintenir des scripts de parsing. Dès que la base dépasse quelques milliers de fiches ou qu’un enrichissement multicanal (téléphone mobile, e-mail personnel) devient nécessaire, la maintenance de règles de normalisation internes devient disproportionnée par rapport au gain.
Avant d’investir, trois questions tranchent la décision : quel volume de candidatures traitons-nous chaque mois, à quelle fréquence la base doit-elle être rafraîchie, et avons-nous les compétences pour maintenir ces règles dans la durée.
— Jules
Comment Kalent met en pratique cette normalisation et accélère le sourcing
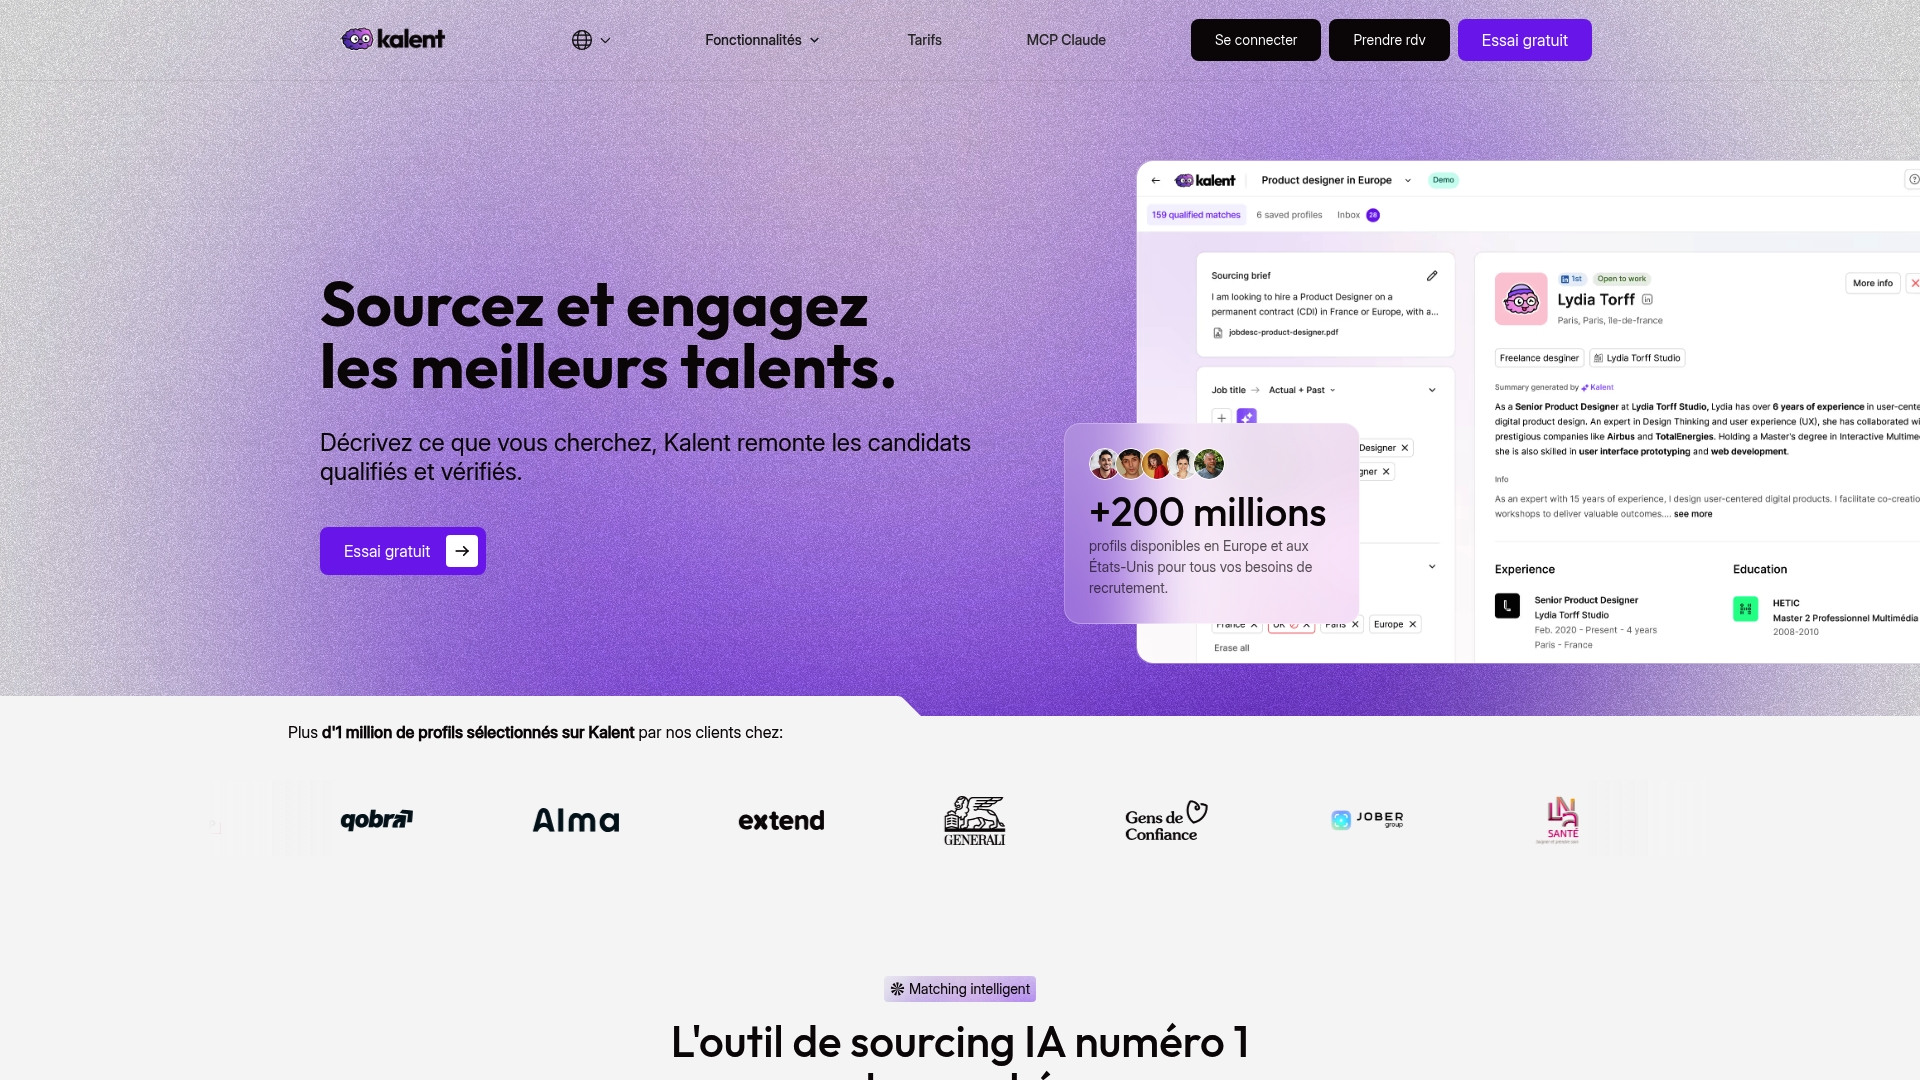
Plutôt que de reconstruire un pipeline de nettoyage et d’enrichissement en interne, nous proposons une base déjà normalisée et prête à l’usage. Notre enrichissement des données donne accès à des contacts directement exploitables (80 % de numéros mobiles, 60 % d’e-mails personnels) sur plus de 200 millions de profils en Europe et aux États-Unis.
- Recherche et filtrage de profils qualifiés sans recherche booléenne.
- Automatisation du contact multicanal (LinkedIn, e-mail, WhatsApp) sur des données déjà formatées correctement.
- Réduction significative du temps de sourcing grâce à cette automatisation.
- Intégration directe avec les ATS pour exporter les profils qualifiés sans ressaisie.
Pour comparer les formules en détail, consultez notre page tarifaire ou réservez une démo.
Questions fréquentes
Qu’est-ce que la normalisation des données candidats exactement ?
L’objectif final est une base unifiée où chaque champ suit une convention unique.
Dans quel ordre faut-il dédupliquer, valider et normaliser ?
L’ordre recommandé est déduplication, puis validation des e-mails et téléphones, puis normalisation des formats, puis enrichissement, puis contrôle qualité final, comme le décrit ce guide sur le nettoyage et la déduplication de données. Dédupliquer en premier évite de normaliser deux fois le même enregistrement sous deux formats différents.
Faut-il automatiser entièrement la fusion des doublons ?
Non : seule une correspondance exacte sur l’e-mail justifie un auto-merge automatisé, tandis que les autres cas doivent passer par une file de revue humaine avant fusion, selon les pratiques décrites pour la détection de doublons dans un pipeline de candidats. Cette prudence évite de fusionner par erreur deux profils distincts qui partagent un nom proche.
Quel format de téléphone privilégier pour des campagnes internationales ?
Le format E.164 reste la référence, avec une longueur maximale de 15 chiffres et une structure indicatif pays plus numéro national, selon la recommandation ITU-T E.164. Ce format garantit un routage fiable quel que soit le pays d’origine du contact.
Comment vérifier qu’une base candidats est prête pour une campagne ?
Un envoi test à faible échelle, une dernière revue humaine sur les fiches incertaines et un import en environnement sandbox avant la bascule en production permettent de valider la base.
Sources
- Recommendation ITU-T E.164 (02/2026) The international public telecommunication numbering plan
- ISO/IEC 5259-3:2024 - Data quality management requirements and guidelines
- How to use AI to detect duplicate candidates pipeline (SHRM)
- RFC 5321 - Simple Mail Transfer Protocol
- PhoneNumberMetadata (libphonenumber)


